Consensis in 40 Sekunden
Wie die Tabellen eines Katalogs zu Daten werden – und welche Zellen noch ein menschliches Auge brauchen.
Dokumentenextraktions-API · auf Korrektheit ausgelegt
Eine falsche Zahl bedeutet ein falsch bestelltes Teil, eine Konstruktion, die nicht passt, ein Angebot, das nicht stimmt. Deshalb vertrauen wir nie einer einzelnen Lesung: Jeder Wert wird mehrfach unabhängig gelesen und gilt nur als verifiziert, wenn die Lesungen übereinstimmen. Jede Zelle zeigt ihr Konfidenzniveau, und die wenigen ungeklärten Werte werden markiert und mit der Originalseite verknüpft — nichts wird stillschweigend geraten.
kostenlos testen: 10 Seiten, ohne Registrierung · danach $0.06 / Seite ($0.036 im Batch) · Mindestaufladung US$3.50 · keine Datenspeicherung
| AMS 15 | AMS 20 | ||
|---|---|---|---|
| A: | Systemhöhe | 24 ✓ | 30 ✓ |
| B: | Wagenbreite | 47 ✓ | 63 ✓ |
| C₀: | Statische Tragzahl (kN) | 18.8 ? OCR-Engine A 18.8 OCR-Engine B 18.8 Layout-Parser 16.6 2 von 3 unabhängigen Lesern stimmen überein — geliefert als nicht verifiziert, mit Link zum Originalausschnitt, damit ein Mensch es in Sekunden klärt. | 28.9 ✓ |
| M₀Q: | Statisches Quermoment (Nm) | 181 ✓ | 340 ✓ |
Auch wir haben uns einmal schwer damit getan, korrekte Daten aus Dokumenten zu holen. Sie müssen das nicht mehr. Eine falsche Tragzahl, eine verschobene Spalte, eine erfundene Teilenummer — Fehler in kritischen Daten haben ernste Folgen, lange nachdem die Tabelle gut aussah. Und ein KI-Modell darauf loszulassen löst das nicht: Selbst die besten Modelle halluzinieren, erfinden plausible Werte und stempeln sie als „hohe Konfidenz“. Deshalb wird hier nichts als wahr angenommen, bis unabhängige Lesungen übereinstimmen. Consensis ist das Werkzeug, das wir für unsere eigenen Kataloge gebaut haben — jetzt teilen wir es.
— warum wir Consensis teilen
Wie die Tabellen eines Katalogs zu Daten werden – und welche Zellen noch ein menschliches Auge brauchen.
Wir bewerten uns an von Hand erstellten Referenzdaten auf Seitenebene — erstellt, bevor irgendein Werkzeug lief, nie gesampelt. Dasselbe offene Bewertungsskript wird auf uns und auf den Wettbewerb angewendet.
| Kennzahl | Consensis | Führender Wettbewerber* |
|---|---|---|
| Zellwerte korrekt | 96% | 92% |
| Ganze Zeilen korrekt | 94% | 75% |
| Tabellenstruktur korrekt | 76% | 58% |
| Rasterkonsistenz | 100% | 99% |
| Keine erfundenen Werte | 99% | 97% |
* Eine führende VLM-basierte Extraktions-API, im agentischen Modus mit höchster Genauigkeit ausgeführt; Ausgaben vor unseren Wiederholungsläufen eingefroren.
Genauigkeit kommt nicht von einem größeren Modell — sie kommt von unabhängigen Lesungen, die übereinstimmen müssen, bevor ein Wert als vertrauenswürdig gilt.
Senden Sie ein PDF über die API oder den Browser. Kataloge, Datenblätter, Preislisten — mit Textebene oder als Scan.
Mehrere OCR-Engines, ein Geometrie-Parser und ein Layout-Modell extrahieren jede Seite, ohne voneinander zu wissen.
Die Lesungen werden Zelle für Zelle verglichen. Übereinstimmung wird verifiziert; Abweichungen werden mit jeder Version und dem Originalausschnitt geliefert.
JSON oder Excel, mit Quelle und Konfidenz pro Zelle. Eine Prüfseite mit Gegenüberstellung für jede Seite, die Sie selbst kontrollieren möchten.
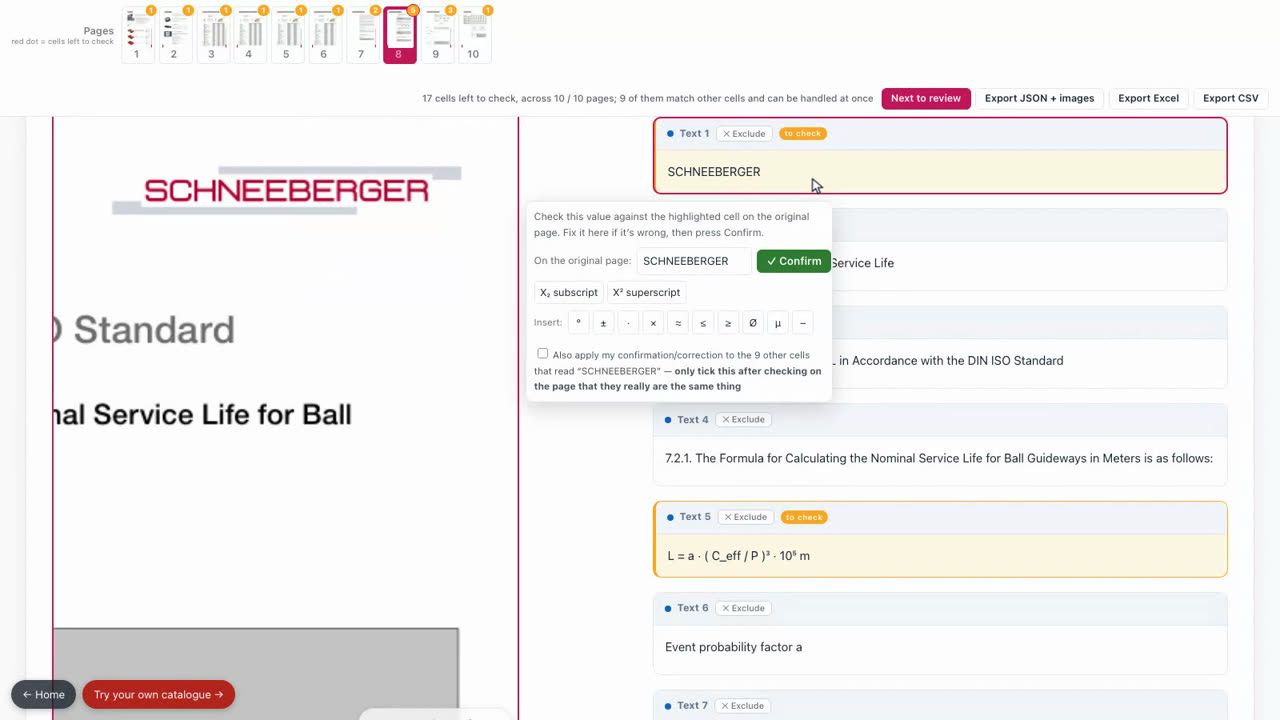
Jeder Auftrag wird mit einer interaktiven Prüfseite geliefert. Im Browser geöffnet, ist jede markierte Zelle einen Klick von der Klärung entfernt — direkt neben der Originalseite. Arbeiten Sie die kurze Liste der Markierungen selbst ab — bei den meisten Dokumenten bleibt nur eine Handvoll.
Klicken Sie auf eine markierte Zelle, und die Originalseite zoomt genau auf die Stelle, mit der Version jedes Lesers.
Die Seite stimmt? Ein Klick. Nicht? Korrektur eintippen — Tiefstellungen und technische Symbole inklusive — und weiter. Ein Button „Nächste Prüfung“ führt Sie durch den Rest.
Excel oder CSV für Tabellenkalkulationen — oder eine ZIP-Datei mit dem korrigierten JSON und jedem Bildausschnitt, genug, um jede Seite nachzubauen. Ihre Änderungen bleiben in Ihrem Browser; wir sehen sie nie.
Prüfen Sie diesen Wert gegen die hervorgehobene Zelle auf der Originalseite. Korrigieren Sie ihn hier, falls er falsch ist, und drücken Sie „Bestätigen“.
X₂ tiefgestelltX² hochgestellt °±×≤Ø
Andere Lesarten: 16.6
Kataloge enthalten Preise und unveröffentlichte Produkte. Wir betrachten Speicherung als Haftungsrisiko, nicht als Wert.
Ergebnisse, Ausschnitte — und der OCR-Cache — werden 24 Stunden nach Abschluss gelöscht. Nichts wird zum Trainieren oder Weiterverkaufen behalten.
DELETE /v1/parse/{id} entfernt einen Auftrag sofort — Sie müssen nicht auf das Zeitfenster warten.
Nach dem Löschen wird ein erneut gesendetes Dokument als völlig neuer Auftrag verarbeitet — und berechnet. Eine Schattenkopie wäre für uns billiger; wir haben keine.
$0.06 / gelieferte Seite
mode=batchConsensis ist in der Beta — mit Google oder E-Mail anmelden, und Sie sind drin. Fragen, Vorschläge, Mengen- und Projektangebote: [email protected] — zum Schreiben brauchen Sie kein Konto.